Awaria jednego zasilacza, uszkodzony dysk albo przerwa w dostawie internetu mogą zatrzymać sprzedaż, produkcję, obsługę mieszkańców czy pracę działu księgowości. To właśnie dlatego serwery wymagają redundancji: firma nie powinna uzależniać działania kluczowych procesów od jednego elementu infrastruktury. Redundancja nie jest dodatkiem dla największych organizacji. Jest sposobem na ograniczenie kosztu przestoju tam, gdzie systemy IT wspierają codzienną pracę.
Przestój rzadko kończy się na komunikacie o niedostępnej aplikacji. Pracownicy tracą dostęp do dokumentów, poczty, systemu ERP, danych klientów i narzędzi produkcyjnych. Klienci nie otrzymują odpowiedzi, zamówienia nie są realizowane, a zespół zaczyna działać ręcznie. W sektorze publicznym konsekwencją może być utrudniona obsługa mieszkańców lub brak dostępu do systemów dziedzinowych. W praktyce koszt awarii obejmuje nie tylko naprawę sprzętu, lecz także utracony czas, opóźnienia, nadgodziny i ryzyko utraty zaufania.
Dlaczego serwery wymagają redundancji, a nie tylko kopii zapasowej?
Backup i redundancja rozwiązują dwa różne problemy. Kopia zapasowa pozwala odtworzyć dane po ich utracie, usunięciu, ataku ransomware albo poważnej awarii. Nie zapewnia jednak ciągłości pracy w chwili, gdy serwer przestaje działać. Odtwarzanie systemu z kopii może trwać godziny, a w bardziej złożonych środowiskach nawet dłużej.
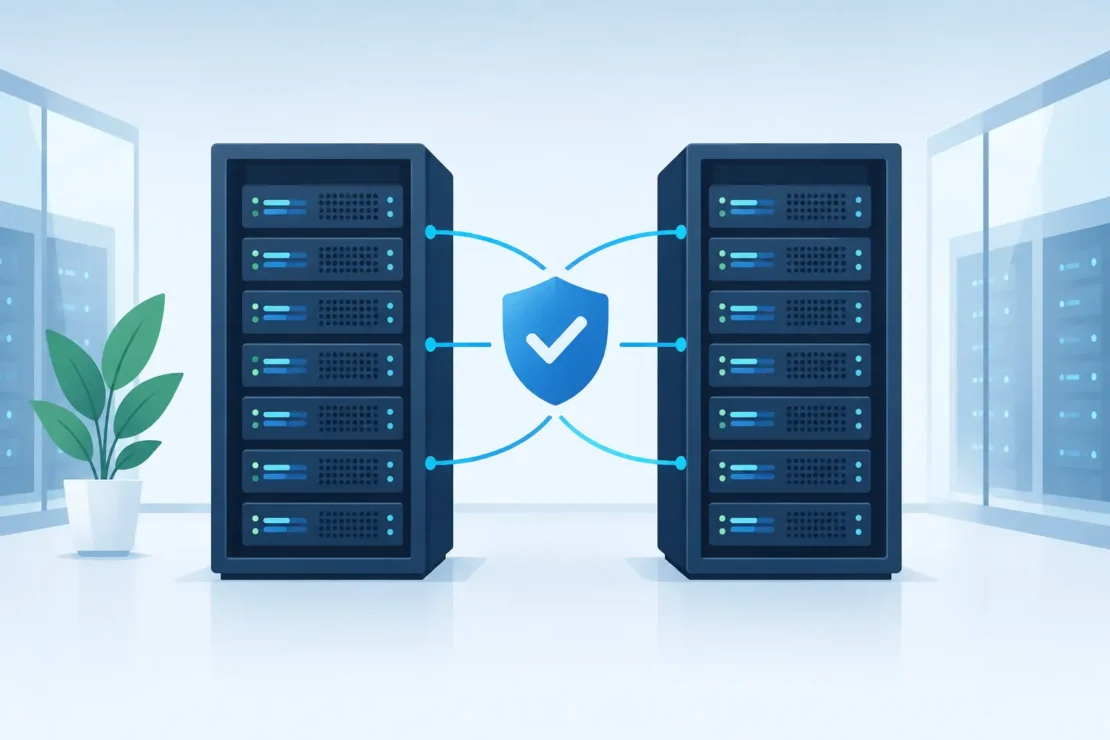
Redundancja ma utrzymać usługę dostępną mimo awarii pojedynczego komponentu. Jeśli jeden dysk ulegnie uszkodzeniu, dane pozostają dostępne na pozostałych dyskach macierzy. Gdy zawiedzie zasilacz, drugi przejmuje jego zadanie. Jeżeli uszkodzeniu ulegnie przełącznik sieciowy lub łącze internetowe, ruch może zostać przekierowany inną drogą. To mechanizm ciągłości działania, a nie metoda archiwizacji danych.
Dojrzałe środowisko potrzebuje obu zabezpieczeń. Redundancja ogranicza skutki awarii operacyjnych, a backup chroni przed utratą danych i umożliwia odtworzenie ich do właściwego punktu w czasie. Jedno nie zastępuje drugiego.
Najczęstsze pojedyncze punkty awarii
Każda infrastruktura ma elementy, których zatrzymanie wpływa na większą część organizacji. Problem pojawia się wtedy, gdy dla danego elementu nie ma alternatywy albo procedury awaryjnej. Nie zawsze chodzi o sam serwer. Często krytyczny punkt znajduje się obok niego – w szafie rack, na styku sieci lub w konfiguracji aplikacji.
W firmowych środowiskach szczególnej uwagi wymagają:
- zasilanie serwera, urządzeń sieciowych i macierzy,
- dyski oraz kontrolery pamięci masowej,
- przełączniki, firewalle i połączenia między lokalizacjami,
- łącza internetowe i urządzenia operatora,
- pojedyncza maszyna obsługująca bazę danych, system ERP lub usługi katalogowe,
- jedna osoba posiadająca wiedzę o konfiguracji bez aktualnej dokumentacji.
Ostatni punkt bywa niedoceniany. Infrastruktura może mieć dwa zasilacze i dwa łącza, ale jeśli po awarii nikt nie wie, jak przełączyć usługę albo gdzie znajdują się hasła administracyjne, organizacja nadal pozostaje podatna na przestój. Redundancja techniczna musi iść w parze z uporządkowanym zarządzaniem środowiskiem.
Redundancja sprzętowa
Najbardziej podstawowy poziom zabezpieczenia dotyczy urządzeń fizycznych. Serwery klasy biznesowej mogą mieć nadmiarowe zasilacze, wentylatory i karty sieciowe. Macierze dyskowe lub serwery z odpowiednio skonfigurowaną macierzą RAID tolerują awarię pojedynczego, a czasem kilku dysków bez natychmiastowej utraty dostępu do danych.
Ważne zastrzeżenie: RAID nie jest backupem. Chroni przede wszystkim przed awarią dysku, ale nie przed przypadkowym skasowaniem plików, błędem aplikacji, szyfrowaniem danych przez ransomware czy uszkodzeniem całego urządzenia. Podobnie dwa zasilacze niewiele pomogą, jeśli oba są podłączone do tej samej listwy zasilającej.
Skuteczna redundancja wymaga rozdzielenia ryzyk. Dwa zasilacze powinny być zasilane niezależnymi torami, a urządzenia sieciowe powinny mieć właściwie zaprojektowane połączenia zapasowe. Nie chodzi o mnożenie sprzętu, lecz o eliminowanie sytuacji, w której jedna usterka wyłącza całą usługę.
Redundancja usług i danych
Dla kluczowych aplikacji sam sprawny serwer nie zawsze wystarcza. Awarii może ulec system operacyjny, baza danych, konfiguracja maszyny wirtualnej albo aplikacja. W takich przypadkach stosuje się klastry wysokiej dostępności, replikację danych między serwerami oraz mechanizmy automatycznego przełączania usług.
Przykładem może być system ERP obsługujący sprzedaż i magazyn. Jeśli działa wyłącznie na jednej maszynie, problem z jej sprzętem lub systemem może zatrzymać wiele działów jednocześnie. Drugi węzeł klastra albo przygotowane środowisko awaryjne pozwala skrócić przerwę do czasu niezbędnego na przełączenie. Zakres rozwiązania zależy od wymaganego czasu dostępności, budżetu oraz możliwości konkretnej aplikacji.
Warto ustalić dwa parametry biznesowe. RTO określa, jak szybko usługa musi wrócić do działania po awarii. RPO wskazuje, jak dużą utratę danych firma jest gotowa zaakceptować, na przykład maksymalnie 15 minut danych transakcyjnych. Te wartości pomagają dobrać technologię bez kupowania rozwiązań niewspółmiernych do faktycznego ryzyka.
Redundancja sieci i dostępu do internetu
Wiele firm koncentruje się na serwerze, zapominając, że użytkownicy muszą jeszcze do niego dotrzeć. Wystarczy awaria jednego przełącznika, urządzenia brzegowego albo łącza, aby sprawna infrastruktura przestała być użyteczna. Dotyczy to szczególnie organizacji korzystających z systemów chmurowych, telefonii VoIP, pracy zdalnej i połączeń między oddziałami.
Dwa łącza od różnych operatorów, odpowiednio skonfigurowany firewall oraz zapasowa ścieżka komunikacji znacząco ograniczają to ryzyko. Nie każda firma potrzebuje dwóch symetrycznych łączy o identycznych parametrach. Dla części organizacji wystarczy łącze podstawowe i zapasowe LTE lub 5G, automatycznie uruchamiane w przypadku awarii. Ważne, aby rozwiązanie było przetestowane, a nie tylko wpisane w dokumentację.
Redundancja ma koszt, ale przestój również
Pytanie nie brzmi, czy nadmiarowość kosztuje. Kosztuje – w sprzęcie, licencjach, energii, konfiguracji i późniejszym utrzymaniu. Pytanie brzmi, ile organizację kosztuje godzina niedostępności konkretnej usługi.
Dla sklepu internetowego będzie to utracona sprzedaż. Dla firmy produkcyjnej – zatrzymana linia i niewykonane zamówienia. Dla biura rachunkowego – brak możliwości terminowej obsługi klientów. Dla urzędu – ograniczona dostępność usług dla mieszkańców. Im wyższa cena przestoju, tym bardziej uzasadnione są zaawansowane mechanizmy wysokiej dostępności.
Nadmierna rozbudowa środowiska też nie jest dobrym rozwiązaniem. Pełna redundancja każdego systemu może być nieopłacalna, zwłaszcza gdy dana usługa może być niedostępna przez kilka godzin bez istotnych konsekwencji. Dlatego decyzje powinny wynikać z klasyfikacji systemów: które są krytyczne, które ważne, a które można odtworzyć w dalszej kolejności.
Jak zaplanować redundancję bez komplikowania IT
Dobry plan zaczyna się od analizy zależności, a nie od zakupu kolejnego serwera. Trzeba ustalić, jakie procesy realizują najważniejsze systemy, gdzie są przechowywane dane, od czego zależą aplikacje i kto odpowiada za reakcję na incydent. Audyt środowiska często ujawnia proste problemy: pojedynczy switch, nieaktualną konfigurację backupu, wspólny punkt zasilania lub brak monitoringu stanu dysków.
Następnie warto określić priorytety dostępności. Systemy finansowe, ERP, poczta, usługi katalogowe, pliki projektowe czy rejestracja zamówień zwykle wymagają innego poziomu ochrony niż archiwum starszych dokumentów. Dopiero po tej ocenie można rozsądnie zdecydować, czy potrzebne są dodatkowe zasilacze, serwer zapasowy, klaster, replikacja do drugiej lokalizacji czy model hybrydowy z wykorzystaniem chmury.
Równie istotne są monitoring i testy. Redundancja, która nie została sprawdzona, pozostaje założeniem. Należy regularnie kontrolować alarmy sprzętowe, pojemność zasobów, stan kopii zapasowych i skuteczność przełączania awaryjnego. Test odtworzenia danych oraz symulacja awarii pokazują, czy deklarowany czas powrotu do pracy jest realny.
W Rabiks projektujemy takie rozwiązania od strony potrzeb operacyjnych klienta: od uporządkowania infrastruktury i zabezpieczenia danych po stałe monitorowanie środowiska. Celem nie jest maksymalna liczba urządzeń, lecz przewidywalna praca firmy nawet wtedy, gdy zawiedzie pojedynczy element.
Najlepszym momentem na ocenę odporności serwerów nie jest dzień awarii. Warto spojrzeć na własne środowisko z prostą perspektywą: co dokładnie stanie się jutro rano, jeśli przestanie działać jeden dysk, jedno łącze, jeden switch albo jeden serwer? Odpowiedź zwykle jasno wskazuje, gdzie potrzebne są pierwsze działania.